Reordenar y omitir trades: la primera línea de defensa contra la suerte disfrazada de ventaja
Tabla de contenidos
Por qué se empieza siempre por aquí
Las pruebas de manipulación de operaciones son las primeras del pipeline por una razón puramente económica: son gratis. No reejecutan el backtest, trabajan sobre la lista de operaciones que ya existe, y por tanto mil simulaciones cuestan segundos.
Eso las convierte en el filtro perfecto para pasar sobre miles de candidatas y quedarte con las que merecen que gastes cómputo de verdad. Su poder predictivo individual no es el más alto de la batería —lo veremos con datos en el artículo 7—, pero su relación entre información obtenida y coste es imbatible.
Randomize Trades Order
Qué hace exactamente
Baraja el orden de las operaciones existentes miles de veces y recalcula la curva de capital para cada permutación.
El detalle que hay que entender antes de interpretar nada
Barajar NO cambia el beneficio neto. Sumar los mismos números en distinto orden da el mismo total. Lo que cambia es el CAMINO: la secuencia de rachas ganadoras y perdedoras, y por tanto el drawdown máximo y la forma de la curva. Si esperas ver variación en el beneficio final de este test, estás mirando la métrica equivocada.
Lo que este test mide es si el drawdown que observaste fue afortunado. Imagina una estrategia con ocho operaciones perdedoras repartidas a lo largo del histórico: el drawdown resultante es suave. Esas mismas ocho pérdidas podrían haber caído consecutivas. El test te dice cuánto habría dolido ese escenario, que es igual de posible.
Configuración recomendada
| Ajuste | Valor | Por qué |
| Número de simulaciones | 1.000 | Es barato: aprovecha para tener significación estadística real |
| Muestra | Use full sample | Usar la muestra completa de operaciones, no un subconjunto |
| Método | Exact | Reordenación exacta de las operaciones existentes |
El filtro: cómo se traduce en un criterio objetivo
Aquí es donde el test deja de ser un gráfico bonito y se convierte en una decisión automática. La configuración habitual del filtro se lee así:
Con un 95 % de confianza, el Return/Drawdown del test debe ser mayor que el 50 % del Return/Drawdown de la estrategia original.
Descompuesto pieza a pieza:
- Columna izquierda (valor del test): selecciona el Monte Carlo correcto —cuidado aquí, es un error frecuente elegir el test equivocado del desplegable— con confianza del 95 % y condición «mayor que».
- Columna derecha (referencia): el dato de la estrategia principal al 50 %, configurado como percentage ratio.
- En configuración de vistas: Left value = test, Right value = original.
El equivalente conceptual: exijo que en el 95 % de los escenarios alternativos mi estrategia conserve al menos la mitad de su eficiencia riesgo-beneficio original. Es un listón exigente pero no absurdo.
El equilibrio de los filtros
Hay que encontrar un consenso entre no hacer los filtros tan rígidos que no pase ninguna estrategia y no hacerlos tan blandos que pasen todas. Un filtro que aprueba el 90 % de las candidatas no está filtrando; uno que aprueba el 0,1 % probablemente esté descartando cosas buenas por ruido.
Una referencia práctica: si tras aplicar un filtro sobreviven más del 30 % de las estrategias, el filtro es demasiado permisivo. Si sobreviven cero, revisa si el criterio es irreal o si la generación inicial produjo pocas candidatas de calidad.
Randomly Skip Trades
Qué hace y qué simula
Elimina aleatoriamente un porcentaje de las operaciones. Al contrario que el barajado, este test SÍ cambia el beneficio neto, porque estás quitando resultados de la suma.
Lo que simula es muy concreto y muy real: operaciones que en el mundo real no habrías ejecutado. Una desconexión, un slippage que impide la entrada, un gap que salta el nivel, o simplemente que en otro bróker el precio no llegó a tocar tu orden. Esta última razón es más importante de lo que parece y volveremos a ella en el próximo artículo.
La trampa de los trades milagro
Una estrategia con 200 operaciones y un profit factor de 1,8 puede ser extremadamente frágil si cinco de esas operaciones acumulan el 80 % del beneficio total. Al eliminar esas cinco con el test de omisión, el sistema colapsa. Y en el mundo real, perderte tres operaciones excepcionales por una caída de conexión te deja sin sistema. Una estrategia robusta reparte su rentabilidad.
Configuración recomendada
| Ajuste | Valor | Comentario |
| Porcentaje omitido | 15 % – 30 % | El 15 % es un filtro suave; el 30 % es la prueba dura |
| Simulaciones | 500 – 1.000 | Sigue siendo barato |
| Apply percentage ratio | 80 % | Referencia habitual para el filtro |
| Criterio de aprobación | Beneficio neto > 0 en el 70 % de las simulaciones | Con el 30 % de operaciones eliminadas |
Cómo leer el resultado en la práctica
Más allá de que el filtro dé verde o rojo, merece la pena mirar el gráfico. La forma de la nube de simulaciones dice cosas que el número no captura.
| Patrón | Lectura |
| La nube empieza estrecha y sigue estrecha | Excelente. Las simulaciones se parecen entre sí: el resultado no depende de la suerte. |
| La nube se abre progresivamente en abanico | Normal. La dispersión crece con el número de operaciones acumuladas. |
| La nube se abre de golpe en un punto concreto | Sospechoso. Suele indicar una operación excepcional cuyo efecto domina el resultado. |
| Buena parte de las simulaciones acaba por debajo de cero | La estrategia no tiene margen suficiente sobre el ruido. |
OBJETIVO
Repetido porque es la regla que más se olvida: cuanto más estrecha sea la nube, más robusta es la estrategia. Y la curva original debería estar en el medio o ligeramente por debajo del centro de la nube, nunca destacando por arriba.
Criterios de aceptación de esta fase
| Prueba | Criterio mínimo |
| Randomize Trades Order | 90 % o más de las simulaciones terminan con beneficio neto positivo |
| Randomize Trades Order | La curva original dentro de la nube, no en el extremo superior |
| Randomize Trades Order (filtro) | Ret/DD al 95 % de confianza > 50 % del original |
| Skip Trades 30 % | Beneficio neto > 0 en el 70 % o más de las simulaciones |
RECORDATORIO
Del artículo 1: estos criterios se fijan antes de ejecutar. Si al ver los resultados te descubres pensando «bueno, con un 85 % también valdría», para. Eso es exactamente el sesgo que las pruebas existen para evitar.
Una limitación que hay que tener presente
Estas dos pruebas comparten la suposición de independencia entre operaciones que vimos en el artículo anterior. Si tu estrategia tiene dependencia entre trades —el tamaño de una depende del resultado de la anterior, o hay simetría forzada entre posiciones— los resultados de esta familia no son interpretables.
En esos casos, sáltate esta fase y ve directamente a las pruebas de retest completo, donde se reejecuta toda la lógica y las dependencias se respetan. Perderás velocidad de filtrado, pero al menos los números significarán algo.
Preguntas frecuentes (FAQs)
Las dudas que más se repiten sobre este tema, con la respuesta contrastada con la documentación oficial de StrategyQuant X.
Si barajar no cambia el beneficio neto, ¿qué métrica miro?
El drawdown y las métricas que lo incorporan, principalmente Return/Drawdown. Sumar los mismos resultados en distinto orden da el mismo total, pero el camino cambia: cambia la profundidad de las rachas y, por tanto, la caída máxima.
Visualmente, el objetivo es que el conjunto de simulaciones sea lo más estrecho posible y que la curva original quede en el centro o ligeramente por debajo, nunca destacando por arriba.
¿Puedo exigir Return/Drawdown al 100 % de confianza?
Sí, y es un criterio muy usado: Return/Drawdown mayor o igual que cero con nivel de confianza del 100 %. Traducido, exige que en la peor de las mil simulaciones la relación beneficio/riesgo siga siendo positiva.
Es más estricto de lo que parece a primera vista, y es compatible con el filtro de Return/Drawdown al 95 % descrito más arriba: el primero fija un suelo absoluto, el segundo mide cuánta eficiencia conserva la estrategia en el escenario típico desfavorable.
El Net Profit al 95 %, ¿lo comparo con el backtest original o con el propio test?
Se puede hacer de las dos maneras y el panel de filtrado lo distingue. Comparar contra el backtest principal responde a «¿cuánto pierde la estrategia respecto a lo que vi?». Comparar contra el propio Monte Carlo responde a «¿cuánta dispersión hay dentro de la distribución simulada?».
Un criterio habitual es pedir al menos el 50 % del valor del propio Monte Carlo. Lo importante es saber cuál de las dos referencias has configurado, porque el mismo número significa cosas muy distintas en cada caso.
¿Cuántos filtros conviene poner en un Monte Carlo?
Pocos y bien elegidos. Un error frecuente es acumular condiciones hasta llenar el panel: la mayoría acaban midiendo lo mismo con distinto nombre, y el resultado no es un filtro más estricto sino un proceso más lento y más difícil de diagnosticar cuando no pasa nadie.
Con tres condiciones que ataquen cosas distintas —relación riesgo/beneficio, capacidad de ganar y profundidad del drawdown— tienes cubierto lo que este test puede decirte.
Mi filtro no descarta nada, o lo descarta todo. ¿Qué reviso?
Primero, que el filtro apunte al test correcto. Hay varios Monte Carlo en el desplegable y sus nombres se parecen; elegir el equivocado es el error más común y hace que el criterio se evalúe contra un resultado que no existe.
Después, la calibración por instrumento. Un juego de filtros afinado para índices y oro descarta casi todo aplicado a divisas. Si pasan demasiadas, aprieta antes de lanzar la siguiente tanda; si no pasa ninguna, comprueba que el criterio es alcanzable en ese activo.
¿Omito el 15 % o el 30 % de las operaciones?
El 15 % es un filtro suave y el 30 % es la prueba dura. Para una primera criba sobre miles de candidatas, el 15 % basta; para las que ya han superado varias fases, el 30 % con la exigencia de beneficio neto positivo en el 70 % de las simulaciones separa bien las estrategias cuyo resultado depende de un puñado de operaciones excepcionales.
Mi estrategia tiene pocas operaciones. ¿Sirve de algo este test?
Con muy pocas operaciones, barajar y omitir produce una distribución que dice más del tamaño de la muestra que de la estrategia. Antes de interpretar un Monte Carlo conviene tener un mínimo de operaciones que dé significación estadística; con estrategias de temporalidad alta y pocas decenas de operaciones en diez años, el resultado del test es poco más que ruido.
¿Aplico esto sobre el in-sample o sobre toda la data?
Sobre los datos que tenga configurada la tarea, teniendo en cuenta el comportamiento de la casilla Full Sample que se explicó en el artículo anterior: sin marcar, solo in-sample. Si sigues el flujo de tareas separadas, cuando llegues a esta fase la estrategia ya habrá pasado el retest fuera de muestra y estarás trabajando con la data unificada.
Sigue leyendo el contenido de esta serie
Pasamos a la familia de retest: aleatorización del histórico de precios, del spread y del slippage. Aquí está el ajuste peor entendido de todo StrategyQuant, y configurarlo mal invalida el test por completo.
Desconfía de tu propio backtest
La filosofía de las pruebas de robustez y por qué son el paso más importante del proceso. Tabla de...
Monte Carlo, de verdad
Fundamentos del método, los dos tipos que existen en SQX y cuándo sus resultados no valen nada...
Aleatorizar el mercado
Histórico de precios, spread y slippage: qué te dicen realmente sobre tu bróker. Tabla de...
El espacio de parámetros
Aleatorización, optimización secuencial y SPP: ¿estás en una meseta o en un pico? Tabla de...
Walk-Forward
WFO y la Matrix: robustez en el tiempo, no en el espacio de parámetros. Tabla de contenidos Este...
Qué tests funcionan de verdad
El estudio empírico de StrategyQuant sobre 500.000 estrategias, y un error que conviene corregir....
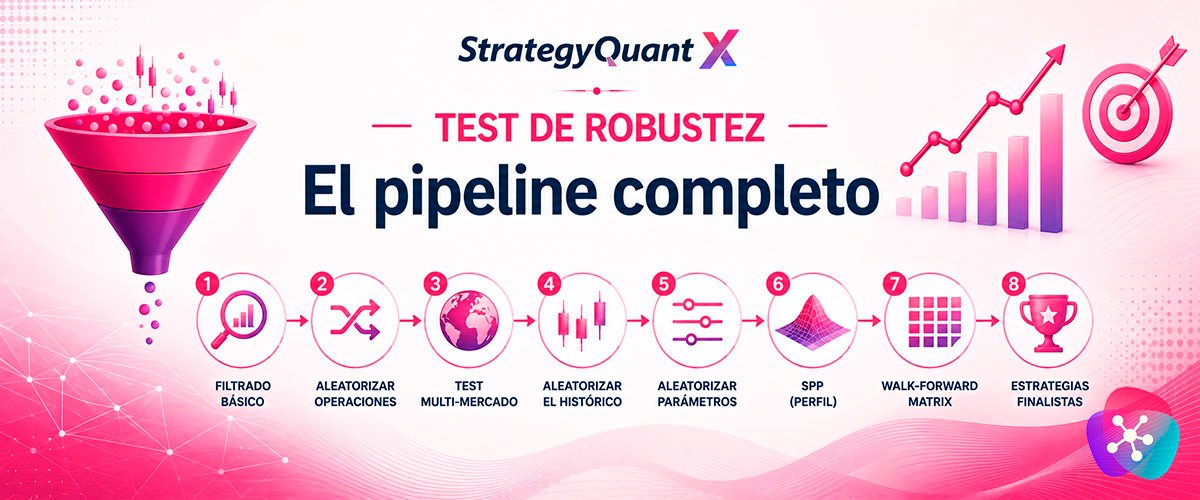
El pipeline completo
Del databank a las finalistas: montaje, filtros, checklist y los errores que más caro salen. Tabla...
AVISO
Este artículo es material formativo. Describe un proceso de validación estadística, no una promesa de rentabilidad: ninguna batería de pruebas convierte una estrategia sin ventaja real en una rentable.
El trading conlleva riesgo real de pérdida de capital. Las cifras y nombres de ajustes corresponden a la documentación de StrategyQuant en el momento de redactar este texto; el programa se actualiza con frecuencia.