Fundamentos del método, los dos tipos que existen en SQX y cuándo sus resultados no valen nada
Tabla de contenidos
De la bomba atómica a tu curva de capital
El método Monte Carlo nació en el Proyecto Manhattan, en los años cuarenta. Stanisław Ulam y John von Neumann se enfrentaban a problemas de difusión de neutrones que no tenían solución analítica: demasiadas variables, demasiada incertidumbre. La idea que tuvieron fue tan simple como potente: si no puedes resolver el problema, simúlalo miles de veces con valores aleatorios y mira qué distribución de resultados sale.
El nombre lo puso Nicholas Metropolis, en referencia al casino de Mónaco donde el tío de Ulam iba a jugar. La aleatoriedad controlada como herramienta de cálculo.
En trading aplicamos exactamente la misma lógica. Tu backtest produce una única curva de capital. Monte Carlo genera miles de curvas alternativas y te enseña la distribución. Eso convierte una respuesta única y engañosa —«esta estrategia ganó 40.000 euros»— en una respuesta honesta: «esta estrategia produce entre 8.000 y 55.000 euros según cómo caiga la moneda, y en el 8 % de los escenarios pierde dinero».
La analogía de la baraja
Imagina que tus 300 operaciones del backtest son 300 cartas. El resultado que obtuviste —tu curva de capital— depende del orden en que salieron. Monte Carlo baraja esas 300 cartas miles de veces y comprueba cuántas combinaciones siguen siendo rentables. Si el 95 % lo son, tienes algo. Si solo el 30 % lo son, la curva original fue una secuencia afortunada.
Los dos tipos de Monte Carlo en StrategyQuant X
Esta distinción es la que más confusión genera, y entenderla bien determina cómo organizas todo tu flujo de trabajo. StrategyQuant separa Monte Carlo en dos cross checks completamente distintos.
Tipo 1: Monte Carlo trades manipulation
Trabaja exclusivamente sobre las operaciones que ya existen del backtest original. La documentación oficial lo dice sin rodeos: no requiere ejecutar backtests, opera sobre los trades ya existentes.
Esto lo hace extraordinariamente rápido. Miles de simulaciones en segundos, porque no está calculando nada del mercado: está reordenando y filtrando una lista de resultados que ya tiene.
- Randomize Trades Order — baraja el orden de las operaciones.
- Randomly Skip Trades — omite operaciones con una probabilidad dada.
Tipo 2: Monte Carlo retest methods
Aquí sí se ejecuta un backtest completo por cada simulación, porque se están alterando cosas que cambian qué operaciones llegan a generarse. Verbatim de la documentación: simula cambios aleatorios en propiedades que requieren que la estrategia sea reejecutada, como cambios en spread, slippage, parámetros de la estrategia o datos históricos.
- Randomize History Data — altera los precios del histórico.
- Randomize Strategy Parameters — altera los valores de los parámetros.
- Randomize Starting Bar — empieza el backtest en barras distintas. La documentación lo justifica así: una buena estrategia no puede ser sensible a en qué barra empiezas el test.
- Aleatorización de spread y slippage — varía los costes de transacción.
| Tipo 1 — Trades manipulation | Tipo 2 — Retest methods | |
| Reejecuta el backtest | No | Sí, uno por simulación |
| Velocidad | Segundos | Minutos u horas |
| Qué altera | El orden y la presencia de operaciones | Los datos, los costes y los parámetros |
| Uso en el pipeline | Primer filtro, sobre todo el databank | Sobre las supervivientes |
CLAVE PRÁCTICA
La consecuencia práctica: el Tipo 1 es tu red de arrastre y el Tipo 2 tu bisturí. Ejecutar el Tipo 2 sobre miles de estrategias sin haberlas cribado antes con el Tipo 1 es tirar días de cómputo.
Cómo se lee un informe de Monte Carlo
Los niveles de confianza
Esta es la parte que más gente interpreta al revés. La documentación oficial lo explica así: los valores al 80 % de confianza significan que hay un 20 % de probabilidad de que el beneficio neto, el drawdown y demás sean PEORES que esos valores.
Es decir, el número que lees no es el resultado esperado. Es el suelo que aguanta ese porcentaje de escenarios. Cuanto más alto el nivel de confianza que exijas, más pesimista es la cifra que obtienes.
detalle que ahorra frustración
StrategyQuant solo admite estos niveles de confianza: 50, 60, 70, 80, 90, 92, 95, 97, 98, 99 y 100. Cualquier otro valor no produce resultado alguno. Si has configurado un 85 % y no ves nada, no es un fallo del programa.
La primera fila de la tabla de resultados muestra siempre los valores de la estrategia original, para que puedas comparar. Las siguientes muestran los valores a cada nivel de confianza.
El gráfico y la nube de simulaciones
| Lo que ves | Diagnóstico |
| La curva original en el centro de la nube, con la mayoría de simulaciones en positivo | Robusta. La rentabilidad no depende de la suerte en el orden. |
| La curva original muy por encima de la nube | Sobreajuste. La secuencia real fue excepcionalmente afortunada y lo probable es peor. |
| La nube colapsa a negativo en más del 30 % de las simulaciones | Sin ventaja real. Descartar. |
| La nube muy estrecha, simulaciones parecidas entre sí | Alta consistencia. Excelente señal. |
| La curva original en la zona baja de la nube | Ambiguo. Puede ser robusta con una ejecución original desfavorable. |
La regla visual que resume todo: buscas que la nube sea lo más estrecha posible y que la curva original esté en el medio o ligeramente por debajo. Cuanto más estrecha la nube, más robusta la estrategia.
Cuántas simulaciones
El número de simulaciones determina la significación estadística del resultado. Con cincuenta simulaciones no tienes una distribución, tienes un rumor.
| Simulaciones | Uso |
| 50 o menos | Insuficiente. No usar para decidir nada. |
| 200 | Mínimo razonable para filtrado en masa |
| 1.000 | Recomendado para las pruebas de manipulación de trades, que son baratas |
| 100–200 | Suficiente en las pruebas de retest, que son caras |
El equilibrio es evidente: en el Tipo 1 puedes permitirte mil simulaciones porque cuestan segundos. En el Tipo 2, cada simulación es un backtest completo, así que doscientas ya suponen horas.
Cuándo Monte Carlo NO significa nada
Esta es la parte que casi ningún tutorial menciona y que invalida análisis enteros. El método Monte Carlo asume que las operaciones son independientes entre sí. Cuando esa suposición no se cumple, barajar y omitir operaciones produce escenarios que no podrían haber ocurrido, y los resultados no son interpretables.
Caso 1: operaciones dependientes
Si tu sistema decide la siguiente operación en función del resultado de la anterior —martingala, antimartingala, aumentar tamaño tras una ganancia, pausar tras dos pérdidas—, las operaciones no son independientes. Barajar el orden crea secuencias imposibles: estás simulando que una operación de tamaño doble ocurrió sin la ganancia previa que la habría justificado.
Caso 2: simetría forzada
Si el sistema fuerza simetría entre operaciones —por ejemplo, cerrar una posición larga abre automáticamente una corta, o hay dependencias de cobertura entre posiciones—, tampoco son independientes. El conjunto de operaciones es en realidad un conjunto de pares, y tratarlas como unidades sueltas rompe la estructura.
Caso 3: gestión monetaria acumulativa
Si el tamaño de posición depende del capital acumulado, el orden importa de verdad. Una racha perdedora al principio reduce el tamaño de todas las operaciones siguientes. Aquí Monte Carlo de reordenación sí aporta información, pero hay que interpretarla sabiendo que la dispersión que ves incluye el efecto del sizing, no solo la suerte en la secuencia.
CLAVE PRÁCTICA
Si al leer el código de tu estrategia encuentras que una operación consulta el resultado de otra, desconfía de los tests de manipulación de trades. Los de retest completo siguen siendo válidos, porque ahí se reejecuta toda la lógica.
Un aviso sobre errores de visualización
En la práctica se dan ocasionalmente inconsistencias en el informe: valores que no cuadran entre pestañas, cifras que no corresponden al resultado real de la estrategia. Es un problema conocido de visualización, no de cálculo.
La solución habitual es sencilla: reejecutar el retest, o reiniciar el programa si persiste. Lo importante es no tomar decisiones con un número que no cuadra con lo que ves en las demás pantallas. Si una métrica te sorprende mucho, verifícala antes de descartar una estrategia por ella.
Preguntas frecuentes (FAQs)
Las dudas que más se repiten sobre este tema, con la respuesta contrastada con la documentación oficial de StrategyQuant X.
Visualmente, Monte Carlo y SPP se parecen. ¿Qué mide cada uno?
Son cosas distintas. El Monte Carlo parte de las operaciones o de las condiciones del backtest y genera variaciones: cambia el orden, elimina operaciones, mueve el spread o los precios. El SPP no toca las operaciones: coge los parámetros de la estrategia, los varía dentro de un rango y ejecuta un backtest completo por cada combinación.
De ahí se derivan las demás diferencias. El Monte Carlo de manipulación de trades es rápido y se usa con unas mil simulaciones; el SPP es lento y se maneja con quince mil o veinte mil permutaciones. Uno responde «¿dependo de la suerte en la secuencia?» y el otro «¿dependo del valor exacto de mis parámetros?».
El botón Full Sample del Monte Carlo, ¿qué datos coge exactamente?
Sin marcar, el Monte Carlo usa solo la parte in-sample. Marcado, usa todo el rango de fechas configurado en la tarea, in-sample más out-of-sample.
La comprobación empírica
Sobre la misma estrategia y la misma tarea, con Full Sample marcado el test trabajó con 314 operaciones; al desmarcarlo bajó a 204. La diferencia confirma que sin marcar la casilla solo se está usando el periodo de entrenamiento.
Y un matiz que resuelve la otra mitad de la duda: Full Sample no significa «todo el histórico disponible en StrategyQuant». Significa todo el rango que tú has seleccionado en esa tarea. Si tienes datos anteriores a la fecha de inicio configurada, no los va a coger.
Entonces, ¿sobre qué datos hago el Monte Carlo?
El flujo que evita el problema de raíz consiste en no depender de esa casilla. Se construye en una tarea que solo ve el in-sample; se valida en otra tarea que solo ve el out-of-sample; y las pruebas de robustez se aplican después, cuando la estrategia ya ha demostrado que no se degrada en datos no vistos, sobre los datos unificados.
Puesto así, la pregunta desaparece: cuando llega el Monte Carlo definitivo, toda la data es tu data, y da igual cómo esté esa casilla.
He configurado un 85 % de confianza y no aparece nada. ¿Es un fallo?
No. StrategyQuant solo admite estos niveles: 50, 60, 70, 80, 90, 92, 95, 97, 98, 99 y 100. Cualquier otro valor no produce resultado. Es una limitación documentada, no un error del programa ni de la configuración.
¿Qué métricas concretas se filtran en el Monte Carlo?
Tres bastan, y cada una mide algo distinto. Return/Drawdown con nivel de confianza del 100 % y valor mayor o igual que cero. Net Profit con confianza del 95 %, exigiendo al menos el 50 % del valor del propio Monte Carlo. Y Drawdown al 95 %, con bastante más margen que las dos anteriores.
Un detalle de configuración que se pasa por alto
En las dos últimas condiciones la referencia es el propio Monte Carlo, no el backtest principal. Es una casilla distinta en el panel de filtrado y cambia por completo el significado del criterio. Antes de lanzar un proceso largo, comprueba contra qué está comparando el filtro.
Esta configuración es exigente y funciona bien en índices y en oro. Para divisas hay que relajarla: cada instrumento tiene su propia personalidad y su propio nivel razonable de estrés.
¿Por qué Return/Drawdown mayor que cero y no mayor que uno?
Porque va acompañado de un nivel de confianza del 100 %. Lo que se está exigiendo es que en la peor de las mil simulaciones la relación entre beneficio y riesgo siga siendo positiva. No garantiza que la estrategia gane dinero en cualquier escenario, pero sí que en ninguno de los simulados el riesgo se come el retorno.
Pedir un valor mayor que uno con confianza del 100 % sería un listón que prácticamente ninguna estrategia superaría, y un filtro que no aprueba a nadie no aporta información.
¿Uso la condición de la desviación estándar del beneficio?
Esa condición pide que el beneficio de la mejor de las simulaciones esté por debajo de una desviación estándar del beneficio medio. Los propios desarrolladores de StrategyQuant reconocen que es tan estricta que prácticamente ninguna estrategia la cumple. Con dos o dos desviaciones y media puede cumplirse ocasionalmente; con una, no.
Lo mismo ocurre con la condición sobre la media del beneficio de todas las simulaciones: su valor razonable depende tanto del instrumento y del tamaño de cuenta que resulta difícil de calibrar de forma estable.
¿Mil simulaciones siempre?
Mil en las pruebas de manipulación de operaciones, porque cuestan segundos y así el resultado tiene significación estadística real. En las pruebas de retest, donde cada simulación es un backtest completo, cien o doscientas ya suponen horas sobre un databank grande: ahí el número razonable es mucho menor.
Sigue leyendo el contenido de esta serie
Bajamos al detalle de la familia más rápida: aleatorización del orden de las operaciones y omisión de trades. Configuración exacta, filtros recomendados y la trampa de las estrategias que dependen de tres operaciones milagrosas.
Desconfía de tu propio backtest
La filosofía de las pruebas de robustez y por qué son el paso más importante del proceso. Tabla de...
Aleatorizar las operaciones
Reordenar y omitir trades: la primera línea de defensa contra la suerte disfrazada de ventaja...
Aleatorizar el mercado
Histórico de precios, spread y slippage: qué te dicen realmente sobre tu bróker. Tabla de...
El espacio de parámetros
Aleatorización, optimización secuencial y SPP: ¿estás en una meseta o en un pico? Tabla de...
Walk-Forward
WFO y la Matrix: robustez en el tiempo, no en el espacio de parámetros. Tabla de contenidos Este...
Qué tests funcionan de verdad
El estudio empírico de StrategyQuant sobre 500.000 estrategias, y un error que conviene corregir....
El pipeline completo
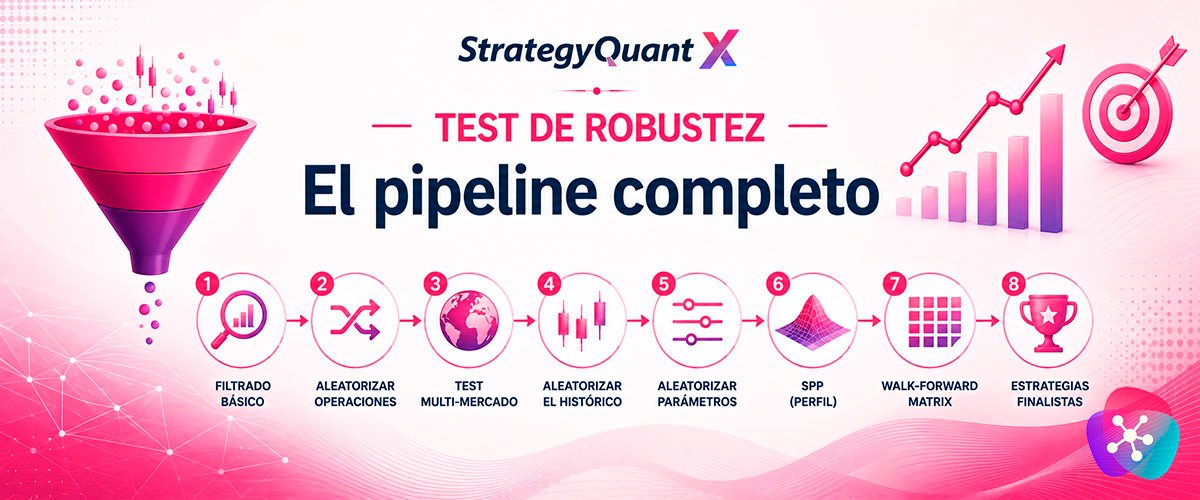
Del databank a las finalistas: montaje, filtros, checklist y los errores que más caro salen. Tabla...
AVISO
Este artículo es material formativo. Describe un proceso de validación estadística, no una promesa de rentabilidad: ninguna batería de pruebas convierte una estrategia sin ventaja real en una rentable.
El trading conlleva riesgo real de pérdida de capital. Las cifras y nombres de ajustes corresponden a la documentación de StrategyQuant en el momento de redactar este texto; el programa se actualiza con frecuencia.