La filosofía de las pruebas de robustez y por qué son el paso más importante del proceso.
Tabla de contenidos
El problema que nadie quiere mirar de frente
Un generador de estrategias como StrategyQuant X produce miles de sistemas por hora. Es una máquina extraordinaria. Y es exactamente por eso que constituye el mayor peligro al que se enfrenta un trader cuantitativo.
Si generas cien mil estrategias sobre un mismo histórico, algunas van a mostrar curvas de capital espectaculares. No porque hayan descubierto nada sobre el mercado, sino porque con cien mil intentos sobre un conjunto fijo de datos, la casualidad produce resultados brillantes. Es el mismo motivo por el que si lanzas mil monedas diez veces cada una, alguna sacará diez caras seguidas. Esa moneda no está trucada. Simplemente estaba en la muestra.
El backtest, por sí solo, no puede distinguir entre esas dos cosas. Muestra la misma curva ascendente para una estrategia que ha capturado una ineficiencia real del mercado y para otra que ha memorizado el ruido de un periodo concreto. Ahí es donde entran las pruebas de robustez.
PREGUNTA FUNDAMENTAL
¿La estrategia es rentable porque ha capturado una ventaja real y persistente del mercado, o es rentable porque el algoritmo ha encontrado la combinación perfecta para este conjunto concreto de datos históricos? Las pruebas de robustez son el único método sistemático para responder a esa pregunta antes de arriesgar capital.
El universo de futuros posibles
El histórico de precios que usas para desarrollar una estrategia es solo una de las infinitas trayectorias que el mercado podría haber seguido. La secuencia exacta de velas que ves en el gráfico fue el resultado que ocurrió, pero no era el único posible ni especialmente probable.
Piénsalo así: si el 15 de marzo de 2018 una orden institucional se hubiera ejecutado treinta segundos más tarde, el máximo de esa vela habría sido dos pips más alto. Un cambio irrelevante para el mercado. Devastador para una estrategia cuya rentabilidad dependa de que ese máximo estuviera exactamente donde estuvo.
Una estrategia verdaderamente robusta es aquella que habría seguido siendo rentable en la mayoría de esas trayectorias alternativas. Las pruebas de robustez construyen artificialmente esos universos paralelos y miden si tu sistema sobrevive en ellos.
CLAVE PRÁCTICA
Esta es la idea que hay que interiorizar antes de tocar un solo ajuste: no estás validando que la estrategia funcionó. Eso ya lo sabes. Estás comprobando si hubiese funcionado en mundos ligeramente distintos del que ocurrió.
Señal contra ruido
Toda la disciplina se reduce a separar dos tipos de estrategia que en el backtest son indistinguibles:
| Tipo | Comportamiento ante las pruebas |
| Estrategia con SEÑAL real | Sigue siendo rentable en la mayoría de escenarios alternativos. Sus parámetros pueden variar dentro de un rango sin que el rendimiento colapse. Funciona en mercados parecidos. Su beneficio está repartido entre muchas operaciones. |
| Estrategia con RUIDO | Solo funciona con la secuencia exacta de datos con la que fue construida. Cualquier variación —de precio, de parámetro, de orden de operaciones— destruye el rendimiento. |
La diferencia no se ve en la curva de capital. Se ve cuando empiezas a romper cosas a propósito.
El principio de desconfianza constructiva
La actitud correcta ante cada estrategia que sale del generador es asumir que es sobreajuste hasta que se demuestre lo contrario. No al revés.
Esto tiene una consecuencia práctica que mucha gente no aplica: el objetivo de las pruebas no es encontrar la manera de aprobar la estrategia, sino encontrar la manera de tumbarla. Si no consigues tumbarla después de someterla a todo lo razonable, entonces —y solo entonces— empiezas a tomártela en serio.
La diferencia entre estas dos mentalidades es enorme en la práctica. Un desarrollador que busca aprobar ajusta los filtros hasta que la estrategia pasa. Uno que busca tumbar define los filtros antes de ejecutar y respeta el resultado.
ATENCIÓN - ERROR GRAVE
Modificar los filtros hasta que la estrategia los supera. Eso tiene nombre en estadística: p-hacking. Los criterios de aceptación se definen ANTES de ejecutar las pruebas y no se tocan después. Si los cambias porque no te gusta el resultado, has convertido la validación en una ceremonia decorativa.
Por qué el orden importa tanto como los tests
Las pruebas de robustez no cuestan todas lo mismo. La documentación oficial de StrategyQuant es explícita: los cross checks se aplican de los simples a los complicados, y si una estrategia no supera el primero se descarta y ni siquiera se le aplica el segundo.
El coste computacional no es un detalle menor. Según la propia documentación, una estrategia sin cross checks puede generarse en 0,2 segundos, pero con la batería completa aplicada puede llevar entre 10 y 200 segundos cada una. Multiplicado por miles de candidatas, la diferencia entre un pipeline bien ordenado y uno mal ordenado son semanas de cómputo.
| Nivel | Contenido típico | Velocidad | Sobre cuántas estrategias |
| Basic | Manipulación de operaciones: reordenar, omitir | Segundos | Miles |
| Standard | Multi-mercado, aleatorizar histórico, spread | Minutos por estrategia | Cientos |
| Intensive | Aleatorizar parámetros, Walk-Forward, SPP | Horas por estrategia | Decenas |
El embudo correcto tiene esta forma: cinco mil estrategias entran en el nivel básico, doscientas llegan al estándar, veinte alcanzan el intensivo. Aplicar tests intensivos desde el principio no hace tu proceso más riguroso; lo hace inviable.
Qué pregunta responde cada familia de tests
Conviene tener claro desde el principio qué está atacando cada grupo de pruebas, porque no son redundantes: cada una rompe una suposición diferente.
| Familia | Suposición que rompe | Pregunta que responde |
| Manipulación de operaciones | Que las operaciones ocurrieron en ese orden y todas se ejecutaron | ¿Dependo de la suerte en la secuencia? |
| Aleatorización de mercado | Que los precios fueron exactamente esos y los costes fueron exactamente esos | ¿Dependo de velas concretas o de un bróker concreto? |
| Aleatorización de parámetros | Que 14 es el periodo correcto del RSI | ¿Estoy en una meseta o en un pico aislado? |
| Multi-mercado | Que la ventaja es específica de este símbolo | ¿He capturado algo general del mercado? |
| Walk-Forward | Que los parámetros fijos valen para siempre | ¿Funciona si reoptimizo periódicamente? |
ATENCIÓN
Una estrategia puede pasar brillantemente cuatro familias y fallar la quinta. Eso no es un aprobado con matices: es un suspenso. Si un test detecta fragilidad, la estrategia es frágil aunque supere diez pruebas más.
El error de intentar arreglarlas
Cuando una estrategia falla las pruebas, la tentación es evidente: añadir una condición, cambiar un filtro, meter un stop distinto. Y funciona, en el sentido de que la nueva versión pasa el test.
El problema es lo que acabas de hacer. Has usado la información del test de robustez para modificar la estrategia. El test ha dejado de ser una validación independiente y se ha convertido en otra ronda de optimización. La versión arreglada pasa el test porque fue construida para pasarlo, no porque sea robusta.
Una estrategia que falla los tests tiene un problema estructural. Descártala y genera candidatas nuevas. Con un generador que produce miles por hora, la escasez no es un problema.
Lo que este proceso no puede hacer
Conviene cerrar con honestidad. Las pruebas de robustez reducen la probabilidad de autoengañarse, que no es poco. Pero no eliminan el riesgo de mercado, no garantizan rentabilidad futura y no compensan una ventaja inexistente.
Hay además un punto incómodo que veremos con datos en el artículo 7 de esta serie: no todos estos tests demuestran ser igual de útiles cuando se mide su capacidad real de predecir el rendimiento futuro. Alguno, según el propio estudio de StrategyQuant, empeora la selección. Aplicar un test porque está en el menú no es rigor.
El objetivo del proceso no es acumular sellos de aprobación. Es llegar a un puñado de estrategias sobre las que puedas defender, con argumentos y datos, por qué crees que tienen una ventaja real.
Preguntas frecuentes (FAQs)
Las dudas que más se repiten sobre este tema, con la respuesta contrastada con la documentación oficial de StrategyQuant X.
¿Cuántas estrategias tienen que sobrevivir al proceso para que sea normal?
Depende de la fase. Un filtro de robustez individual que aprueba más del 30 % de las candidatas no está filtrando gran cosa, y una tasa de entre el 5 % y el 30 % es un rango razonable para cada prueba por separado.
El reparto entre dentro y fuera de muestra es harina de otro costal: es habitual lanzar mil estrategias construidas en la parte in-sample y quedarse con dos o tres tras el retest en la parte out-of-sample. Un 1 % de supervivencia ahí no es señal de que algo vaya mal; es lo normal.
La consecuencia práctica es de planificación: si necesitas veinte finalistas, el número que tienes que generar arriba del embudo es muy grande. Con un generador que produce miles por hora, eso no es un problema, pero conviene saberlo antes de frustrarse.
Si ya separo in-sample y out-of-sample, ¿necesito las demás pruebas?
La documentación de StrategyQuant es explícita al respecto: probar la estrategia en datos desconocidos es la prueba de robustez más básica. Básica en el sentido de fundamental y también en el de insuficiente.
Que una estrategia siga funcionando en datos que no ha visto es la condición mínima. Las demás pruebas atacan cosas que el reparto temporal no cubre: dependencia del orden de las operaciones, de niveles de precio exactos, de un valor concreto de parámetro o de un bróker concreto.
¿Es cierto que StrategyQuant «ve» el out-of-sample configurado dentro del Builder?
Es una sospecha razonada, no un comportamiento documentado por el fabricante. La experiencia de usuarios avanzados apunta a que la separación configurada dentro de una tarea de construcción no es tan hermética como parece sobre el papel.
La solución práctica no exige resolver el debate: basta con construir en una tarea que solo tenga acceso al periodo in-sample y validar en una tarea distinta que solo tenga acceso al periodo out-of-sample. Así la separación es estructural, no una casilla de configuración.
¿El out-of-sample va al principio o al final del histórico?
Hay dos corrientes. La tradicional lo coloca en la parte más reciente, con el argumento de que ese es el mercado más parecido al que vas a operar. La otra lo coloca en la parte más lejana: si la estrategia funciona en un mercado de hace diez o quince años, muy distinto del actual, demuestra una robustez estructural mayor.
El único dato disponible, y sus límites.
En un estudio sobre el oro, con un 20-30 % de out-of-sample, colocarlo al principio del histórico dio un porcentaje sensiblemente mayor de estrategias que después funcionaban (del orden del 21 % frente al 15 %), con diferencia estadísticamente significativa. El análisis se replicó de forma independiente en Python y llegó a la misma conclusión. Pero es un solo activo: no se puede generalizar al resto sin repetir la prueba.
Hay además un matiz de calidad de datos que conviene tener presente. En el histórico muy antiguo abundan los huecos, y un indicador alimentado con datos incompletos devuelve valores disparatados. En futuros, muchos contratos han cambiado de horario de sesión. Antes de concluir que un periodo lejano «funciona peor», comprueba que los datos de ese periodo son utilizables.
¿Puedo trocear el out-of-sample en rodajas y exigir que todas sean rentables?
La idea es atractiva: garantizaría que la estrategia funciona en todos los regímenes de mercado contenidos en el periodo. En la práctica tiene tres problemas serios.
El primero es de validez estadística: si el out-of-sample es el 30 % de los datos y lo partes en rodajas de cinco o seis meses, cada rodaja puede tener quince o veinte operaciones. Con una estrategia de temporalidad alta puedes tener rodajas sin ninguna operación. El segundo es que StrategyQuant no permite implementar esa separación de forma limpia, salvo creando tantas tareas de validación como rodajas. El tercero, y el más importante, es que cada decisión —cuántos trozos, de qué tamaño, qué exigir en cada uno— es un grado de libertad añadido al sistema, y los grados de libertad son exactamente el combustible del sobreajuste.
Si el objetivo es cubrir regímenes distintos, hay una alternativa más simple y más sólida: dos periodos out-of-sample, uno al principio del histórico y otro al final. Cubres condiciones de mercado muy diferentes sin fragmentar la muestra y puedes evaluar cada uno por separado en su propia tarea.
¿Y si con mis criterios no me pasa ninguna estrategia?
Lo primero es distinguir entre un criterio irreal y una generación pobre. Un filtro calibrado para índices o para oro suele ser demasiado exigente aplicado a divisas; un rango de estrés que no ocurre en el histórico real descarta estrategias perfectamente válidas.
Lo que no vale es aflojar los filtros después de ver los resultados. Si vas a ajustar el nivel de exigencia, hazlo como decisión de calibración del proceso —antes de mirar qué estrategias concretas caen— y déjalo fijado para toda la tanda.
¿Cuántos cross checks activo durante la generación y cuáles dejo para el Retester?
La documentación oficial da la cifra que ordena esta decisión: una estrategia sin cross checks puede generarse en 0,2 segundos, y con la batería aplicada puede llevar entre 10 y 200 segundos cada una. En generación conviene dejar solo pruebas baratas y muy selectivas; el resto va al Retester, donde trabajas ya sobre un databank reducido.
El criterio de orden es doble: arriba las pruebas rápidas, y de entre ellas, primero las que más estrategias descartan. Las intensivas —Walk-Forward Matrix, SPP— al final, cuando quedan decenas y no miles.
¿Todo esto sustituye a la fase de demo?
No. Las pruebas de robustez reducen la probabilidad de autoengañarse, no la sustituyen por certeza. Un periodo de demo de seis a ocho meses sigue siendo la única forma de ver el comportamiento del sistema con datos que no existían cuando lo construiste, y con las condiciones reales del bróker.
Sigue leyendo el contenido de esta serie
Entramos en el método Monte Carlo: de dónde viene, qué hace exactamente, los dos tipos que existen en StrategyQuant X y —esto es lo que casi nadie explica— en qué situaciones concretas sus resultados no significan nada.
Monte Carlo, de verdad
Fundamentos del método, los dos tipos que existen en SQX y cuándo sus resultados no valen nada...
Aleatorizar las operaciones
Reordenar y omitir trades: la primera línea de defensa contra la suerte disfrazada de ventaja...
Aleatorizar el mercado
Histórico de precios, spread y slippage: qué te dicen realmente sobre tu bróker. Tabla de...
El espacio de parámetros
Aleatorización, optimización secuencial y SPP: ¿estás en una meseta o en un pico? Tabla de...
Walk-Forward
WFO y la Matrix: robustez en el tiempo, no en el espacio de parámetros. Tabla de contenidos Este...
Qué tests funcionan de verdad
El estudio empírico de StrategyQuant sobre 500.000 estrategias, y un error que conviene corregir....
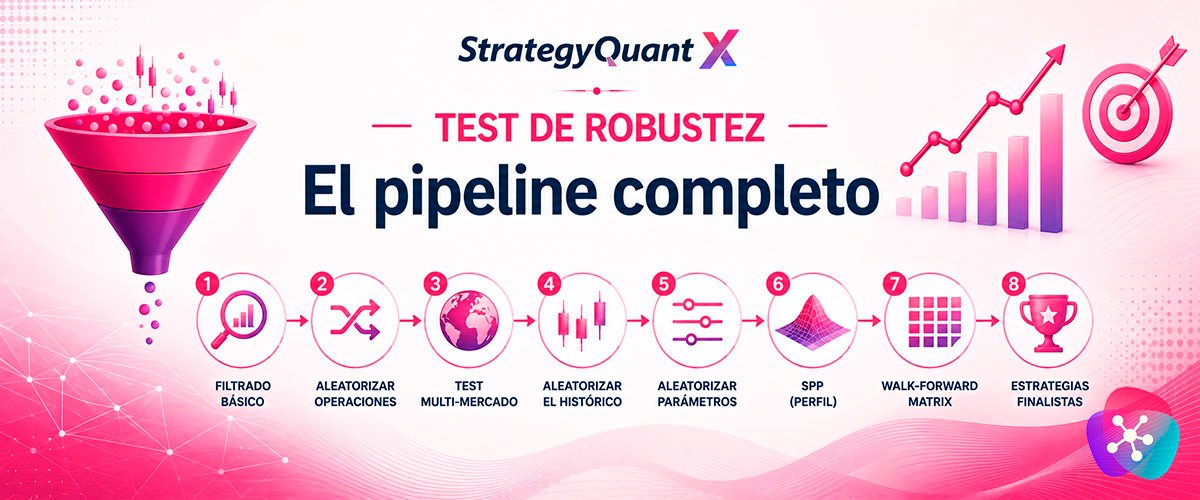
El pipeline completo
Del databank a las finalistas: montaje, filtros, checklist y los errores que más caro salen. Tabla...
AVISO
Este artículo es material formativo. Describe un proceso de validación estadística, no una promesa de rentabilidad: ninguna batería de pruebas convierte una estrategia sin ventaja real en una rentable.
El trading conlleva riesgo real de pérdida de capital. Las cifras y nombres de ajustes corresponden a la documentación de StrategyQuant en el momento de redactar este texto; el programa se actualiza con frecuencia.