Los métodos que separan una estrategia con lógica real de una simplemente ajustada a los datos del pasado.
La fortaleza real de StrategyQuant no está en generar estrategias — eso lo hace cualquier motor de minería de datos. Está en la variedad y profundidad de sus pruebas de robustez, que son las que distinguen una estrategia con una lógica de mercado genuina de una que simplemente memorizó el ruido de un histórico concreto. Diseñar bien los filtros de cada prueba es, probablemente, la habilidad individual más importante de todo el proceso.
Tabla de contenidos
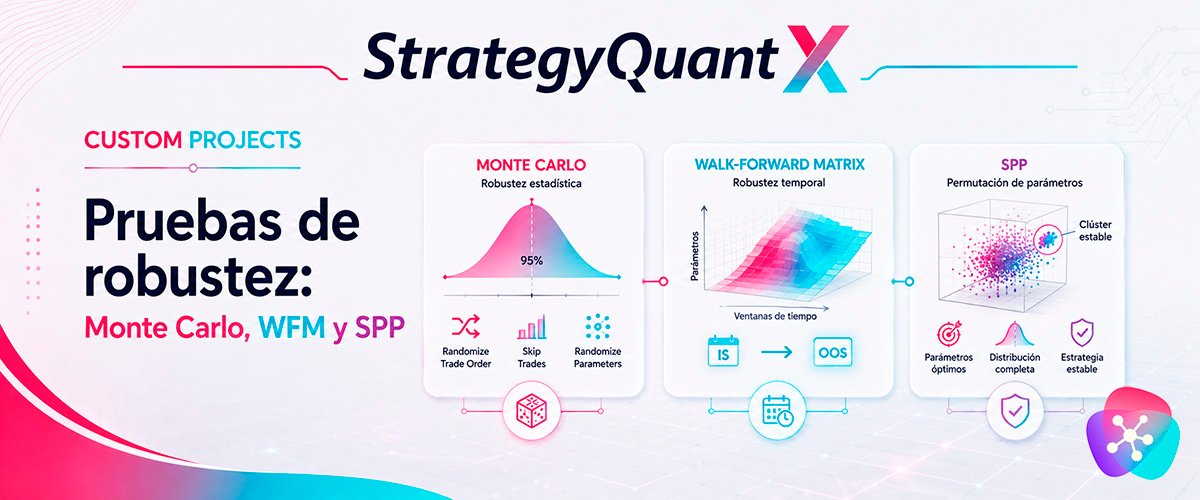
Monte Carlo: manipulación de trades
La primera familia de pruebas de robustez toma las estrategias ya filtradas y las somete a simulaciones donde los trades se manipulan aleatoriamente. No requiere re-backtest completo, así que es relativamente rápida.
| Tipo de manipulación | Qué mide | Velocidad |
| Randomize Trade Order | Si la estrategia depende de que los trades ocurran en una secuencia concreta | Muy rápida |
| Skip Trades (5-10%) | Sensibilidad a fallos de ejecución, slippage extremo o ausencia puntual de liquidez | Muy rápida |
| Add Random Trades | Contaminación por señales falsas | Rápida |
Con 500-1.000 simulaciones se obtienen distribuciones estadísticamente significativas. Un filtro habitual en esta etapa: que el Net Profit en el percentil 5% siga siendo mayor que cero — es decir, que incluso en el peor 5% de los escenarios simulados, la estrategia siga siendo rentable.
Monte Carlo: retest de parámetros e historia
La prueba más exhaustiva de la familia, y la que más tiempo consume, porque requiere re-ejecutar el backtest completo en cada simulación. Mide la sensibilidad de la estrategia a pequeñas variaciones en parámetros, spreads, slippage y datos históricos.
| Tipo de test | Qué mide | Velocidad |
| Randomize Strategy Parameters | Sensibilidad paramétrica: si la estrategia sigue funcionando con parámetros muy cercanos a los originales | Lenta |
| Randomize OHLC History Data | Dependencia de las características exactas de los datos históricos usados | Muy lenta |
| Randomize Spread/Slippage | Sensibilidad al coste de transacción | Lenta |
Con 200-500 simulaciones ya se obtienen resultados fiables — cada una implica un backtest completo, así que más simulaciones significan más tiempo de cómputo. Un filtro clave en esta etapa es el ratio entre el Profit Factor obtenido en las simulaciones Monte Carlo y el obtenido en el período Out-of-Sample: si ese ratio cae por debajo de 0.7, es una señal de que la estrategia está sobreoptimizada — degrada demasiado al introducir variaciones pequeñas y realistas.
CLAVE PRÁCTICA
Según análisis empíricos de la propia comunidad de StrategyQuant, el test de aleatorización de datos históricos (Randomize OHLC Data) y el test Multi-Market son los que muestran mayor correlación con el rendimiento real futuro fuera de muestra. Dales prioridad si tienes que elegir dónde invertir el tiempo de cómputo disponible.
System Parameter Permutation (SPP)
Método desarrollado originalmente por Dave Walton y Robert Pardo. Ejecuta una optimización completa de todos los parámetros de la estrategia y analiza la distribución de resultados obtenida. Una estrategia robusta muestra una distribución concentrada alrededor de sus parámetros originales — un clúster estable —, mientras que una sobreoptimizada solo funciona con valores muy específicos, y el resto de la distribución cae en pérdidas.
Las métricas clave son el Profit Factor mediano y el Net Profit mediano de la permutación: si el valor mediano se acerca al del backtest original, la estrategia es estable; si están muy alejados, la estrategia probablemente ajustó parámetros a ruido específico del histórico usado.
Walk-Forward Matrix (WFM) y Walk-Forward Optimization (WFO)
La prueba reina de robustez temporal. Divide el histórico en múltiples ventanas de entrada (In-Sample) y salida (Out-of-Sample) superpuestas, y comprueba si la estrategia mantiene parámetros óptimos estables a lo largo de esas ventanas. El Walk-Forward Optimization, además, optimiza en cada segmento IS y valida en su OOS correspondiente, encadenando todos los períodos de validación en una única curva de equity compuesta.
| Escenario | Interpretación |
| Curva WFO rentable + curva original rentable | Estrategia robusta, con beneficio real de la re-optimización periódica |
| Curva WFO rentable + curva original no rentable | La estrategia solo funciona con re-optimización constante — señal de peligro |
| Curva WFO no rentable | La estrategia no funciona independientemente de la optimización; descártala |
El objetivo ideal es que el WFO mejore ligeramente el resultado original, pero que ambas curvas sean rentables por sí solas — no que una dependa completamente de la otra.
La configuración habitual reparte cada ventana entre un 50-70% de In-Sample y un 30-50% de Out-of-Sample, con al menos 5-8 ventanas encadenadas, exigiendo que más del 60-70% de esas ventanas OOS resulten rentables. El mapa de calor 3D del WFM es la forma más rápida de leer el resultado: si los parámetros óptimos se agrupan en una zona concreta, es buena señal; si aparecen dispersos sin ningún patrón, es la señal contraria.
Test Multi-Market
Comprueba que la estrategia no es específica de un único mercado, sino que captura una lógica más general. Si funciona razonablemente en un segundo mercado correlacionado, esa lógica subyacente es más sólida. Para XAUUSD, un segundo mercado habitual es XAGUSD (plata) o el índice dólar (DXY); para EURUSD, GBPUSD; para el NQ, el YM.
El criterio de éxito no exige que la estrategia sea igual de rentable en el segundo mercado — basta con un Profit Factor superior a 1.0 y ausencia de drawdowns catastróficos. Lo que importa es que la lógica "tenga sentido" también ahí. Elige pares con dinámicas realmente relacionadas: oro y plata, o EUR/USD y GBP/USD tienen sentido; oro y bitcoin, no.
Preguntas frecuentes (FAQs)
¿En qué orden debería encadenar estas pruebas dentro de un Custom Project?
De menos a más exigente en tiempo de cómputo: primero las pruebas de manipulación de trades (rápidas), después Monte Carlo de parámetros e historia, luego Multi-Market, y al final la Walk-Forward Matrix, que suele ser la más lenta. Así descartas cuanto antes las estrategias débiles y no gastas horas de CPU optimizando o validando candidatos que ya deberían haberse caído en un filtro anterior.
¿Cuántas simulaciones Monte Carlo son suficientes?
Como referencia orientativa, al menos 500 para las pruebas de manipulación de trades (rápidas) y 200 para las de retest de parámetros (lentas, porque cada una es un backtest completo). Menos simulaciones que eso empiezan a dar resultados poco significativos estadísticamente.
¿Qué significa que el ratio MCRSP sea bajo?
Que el rendimiento de la estrategia en las simulaciones Monte Carlo se degrada mucho respecto al obtenido en el período Out-of-Sample original. Es la señal más directa de sobreoptimización: la estrategia se ajustó demasiado a un resultado concreto en vez de capturar un comportamiento de mercado que se sostiene bajo variaciones razonables.
¿Es imprescindible pasar por todas estas pruebas?
No para cualquier propósito, pero si el objetivo es una estrategia candidata a cuenta real, saltarse capas de robustez aumenta directamente el riesgo de llevar a producción una estrategia sobreoptimizada. El artículo de la serie sobre filtros y ranking explica cómo dosificar la exigencia de cada capa sin descartar candidatos válidos demasiado pronto.
Sigue leyendo el contenido de esta serie
Custom Projects en StrategyQuant: la guía completa
Qué son, cómo funcionan y por qué son la herramienta que separa a un trader que prueba cosas...
Cómo crear tu primer Custom Project en StrategyQuant
La interfaz explicada pantalla por pantalla y zona por zona, cómo crear tu primer proyecto y qué...
Catálogo completo de tareas en Custom Projects de StrategyQuant
Todas las tareas disponibles para construir un flujo — qué hace cada una, cómo se configura y...
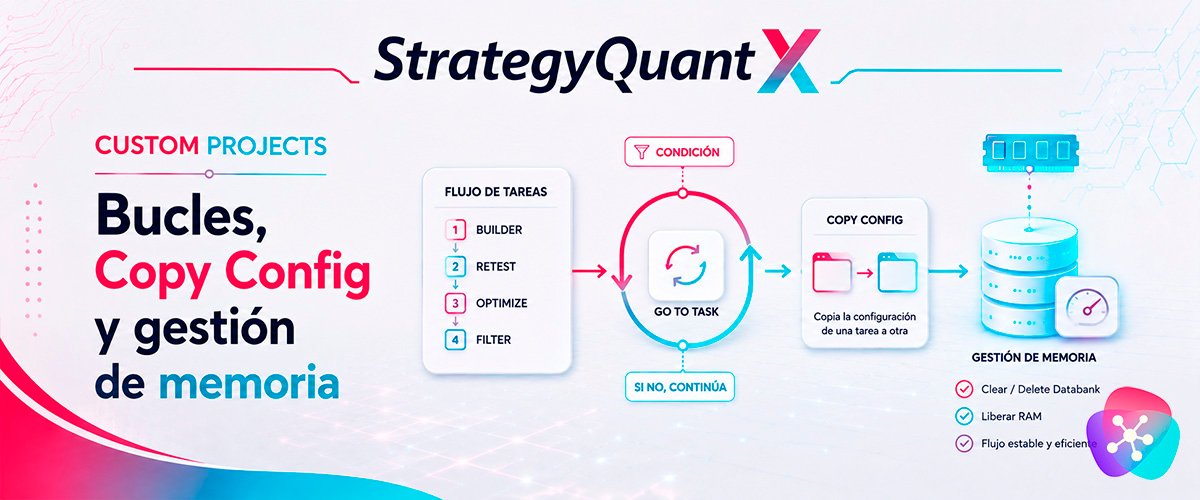
Bucles, Copy Config y gestión de memoria en Custom Projects
Cómo automatizar la repetición de un flujo con Go To Task, evitar errores de configuración con...
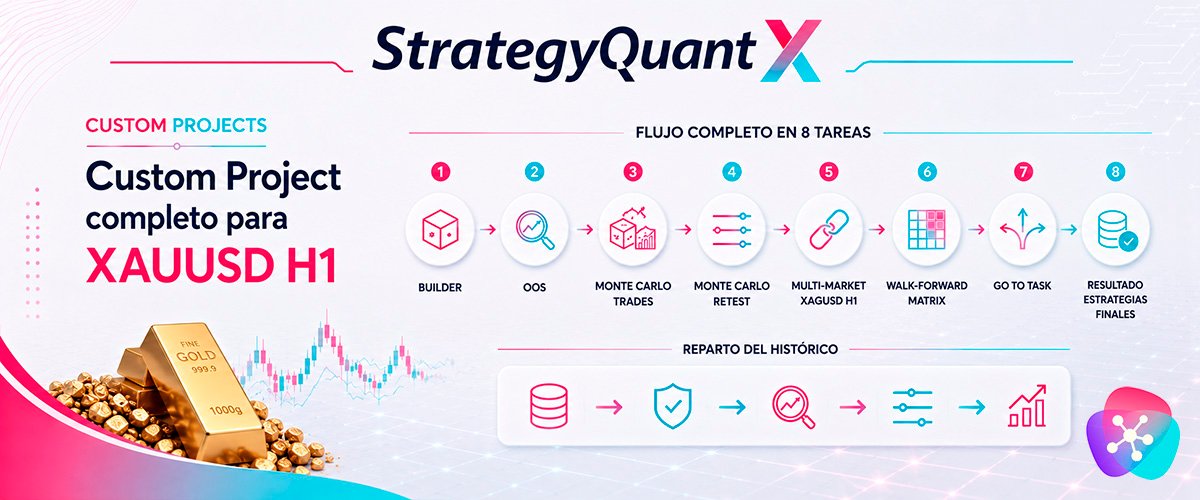
Custom Project completo para XAUUSD H1: flujo paso a paso
Un flujo de trabajo profesional real, tarea por tarea, con los databanks, filtros y resultados...
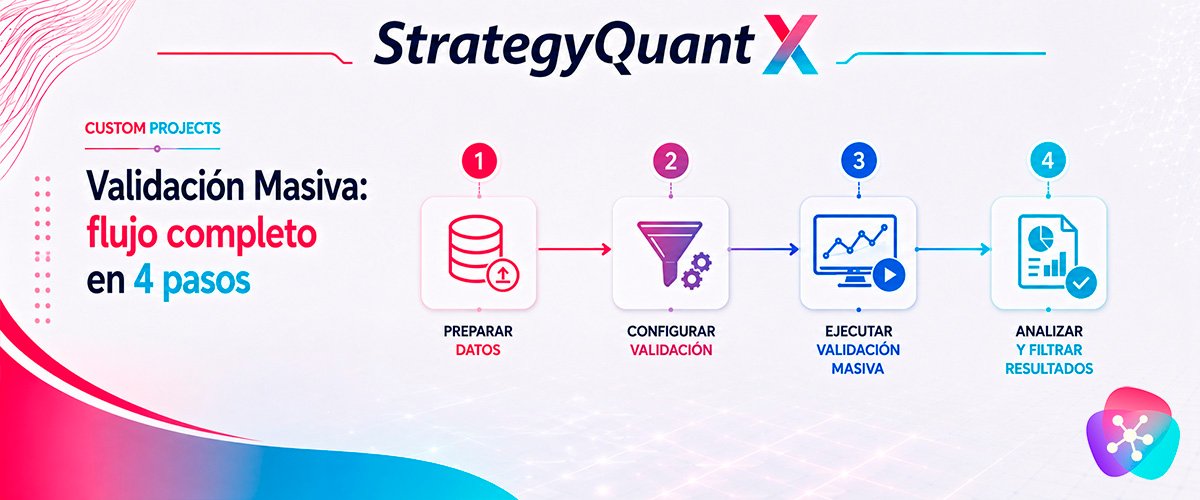
Validación Masiva en StrategyQuant: el flujo completo en 4 pasos
Cómo generar miles de estrategias candidatas y filtrarlas progresivamente —retest por lotes, Monte...
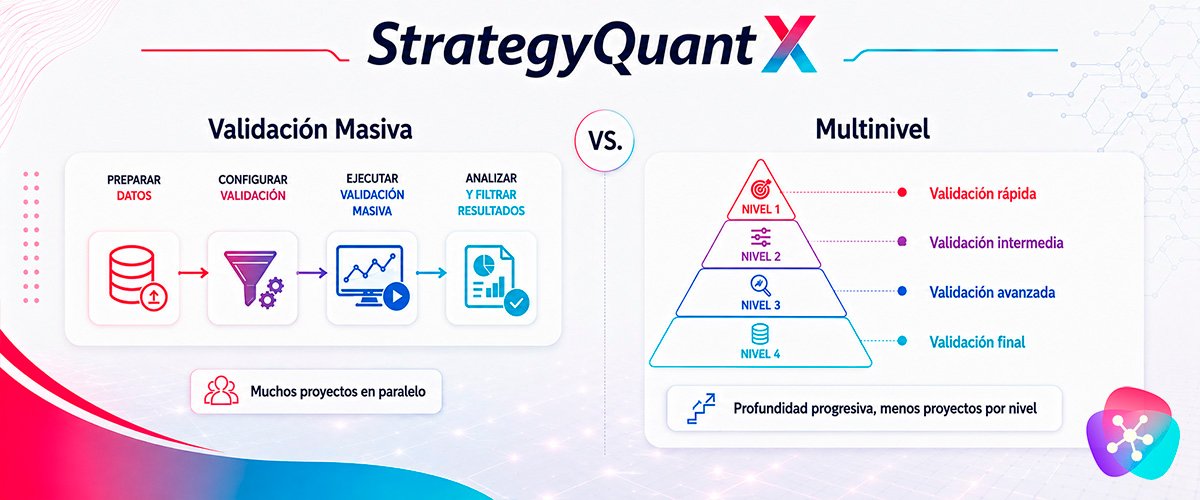
Validación Masiva vs. Multinivel: dos metodologías de Custom Project
Cuándo conviene cada enfoque, cómo gestionar el brazo short, instalar indicadores externos y qué...
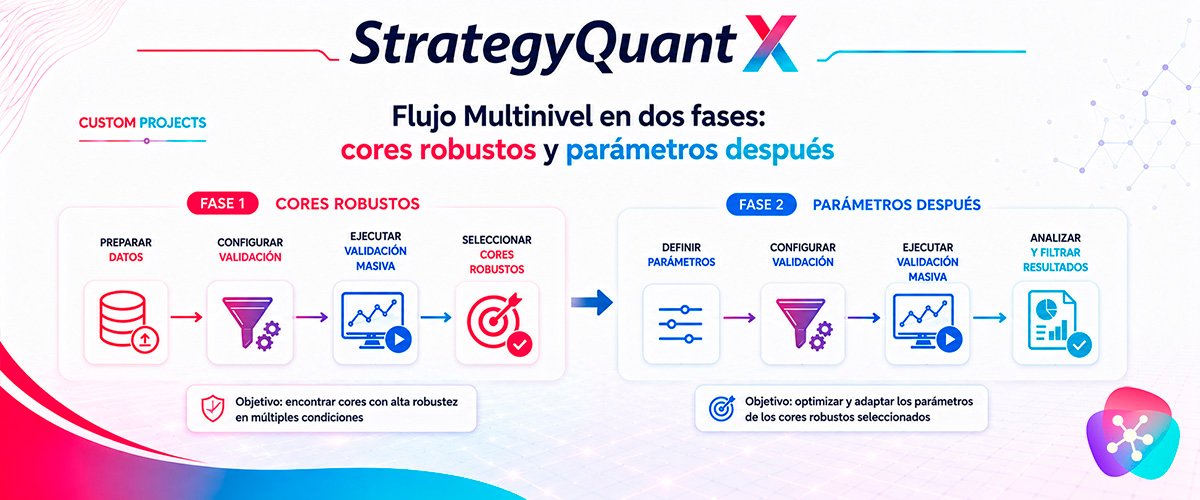
Flujo Multinivel en dos fases: cores robustos y parámetros después
La metodología completa —Fase 1 para encontrar la lógica, Fase 2 para pulirla y estresarla— con su...
Errores frecuentes y checklist final en Custom Projects
Los fallos conceptuales y de configuración más habituales, y la lista de verificación antes de...