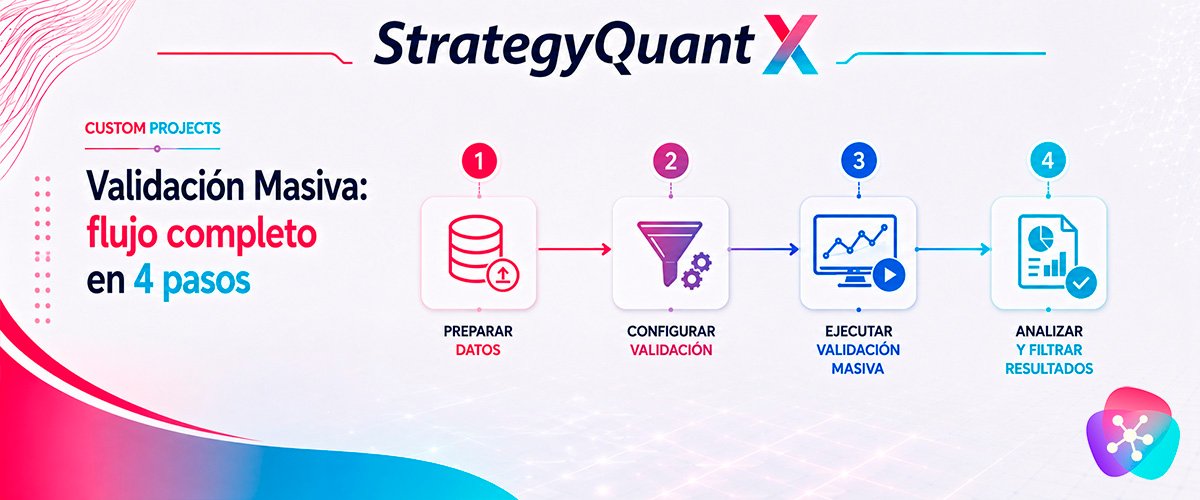
Cómo generar miles de estrategias candidatas y filtrarlas progresivamente —retest por lotes, Monte Carlo, Walk-Forward Matrix y filtrado avanzado del databank— hasta quedarte solo con las "bolas blancas".
Un generador de estrategias (Builder) es, por su propia naturaleza, una máquina de sobreoptimizar: si le das tiempo suficiente, siempre acabará encontrando una combinación de parámetros que se ajusta a la perfección al histórico que le has dado. El problema es que ese ajuste perfecto al pasado no garantiza nada sobre el futuro — cuanto mejor encaja una estrategia con unos datos concretos, mayor es el riesgo de que ese encaje sea puro azar y no un patrón de mercado real.
IMPORTANTE
Una estrategia con Profit Factor de 4 y drawdown mínimo en el backtest puede ser completamente inútil en real si sus parámetros están sobreoptimizados. La métrica más importante nunca es el rendimiento histórico en sí, sino la evidencia de que ese rendimiento se sostiene fuera de la muestra.
La Validación Masiva invierte el planteamiento habitual: en vez de perseguir la estrategia "perfecta", genera un universo amplio de candidatas y las somete a filtros cada vez más exigentes. La lógica es estadística — si generas miles de estrategias y les aplicas pruebas de robustez rigurosas, las pocas que sobrevivan tendrán una probabilidad genuinamente alta de comportarse bien en mercado real.
CLAVE PRÁCTICA
El objetivo de esta metodología no es encontrar la mejor estrategia posible, sino conseguir que un 70-80% de las que superen todo el proceso sean rentables en real. Se busca un conjunto estadísticamente sólido, no una única joya.
Tabla de contenidos
Visión general del embudo en 4 pasos
| Paso | Etapa | Descripción | Resultado esperado |
| 1 | Generación masiva | Builder en el activo elegido, con configuración abierta (pocas condiciones, varias islas). | 5.000-10.000 estrategias |
| 2 | Retest cruzado de mercados | Retest en un mercado distinto pero correlacionado, filtrando por Profit Factor > 1. | Una pequeña fracción del universo inicial |
| 3 | Robustez estadística | Monte Carlo (confianza > 90%) + filtro de Ratio Retorno/Drawdown. | Un subconjunto reducido de candidatas |
| 4 | Walk-Forward Matrix + OOS | Pendiente Out-of-Sample igual o mejor que la In-Sample. | Menos del 1% del universo inicial |
Cada paso actúa como un filtro adicional. No hace falta acertar a la primera con los parámetros de cada fase: es habitual ajustar los umbrales entre tiradas según cuántas estrategias sobreviven y cuánto tiempo de cómputo tienes disponible.
CLAVE PRÁCTICA
Como referencia de magnitud de una tirada real: partiendo de varios miles de estrategias generadas en un índice, el retest cruzado en un segundo índice correlacionado puede dejar en torno a un 5% del universo inicial; el Monte Carlo más el filtro de Retorno/Drawdown recorta de ahí en torno a un 25-30% adicional; y la Walk-Forward Matrix, el filtro más duro, suele dejar pasar solo un dígito bajo de porcentaje de lo que llegó a esa fase. El resultado final —las "bolas blancas"— acaba representando bastante menos del 1% del punto de partida. Estas proporciones varían mucho según el activo y la exigencia de cada filtro, pero dan una idea realista de cuánto se reduce el universo en cada etapa.
Paso 1: generación inicial — construir el universo
El objetivo de esta fase es generar el mayor número posible de estrategias diversas. La cantidad importa porque el filtrado posterior eliminará a la inmensa mayoría: se necesita un universo amplio para que los supervivientes finales sean estadísticamente significativos.
| Parámetro | Valor recomendado | Justificación |
| Dirección | Long y short a la vez | Salvo que el activo tenga un sesgo direccional muy marcado, conviene explorar ambas direcciones en la misma tirada. |
| Condiciones de entrada | 1 a 3 condiciones | Limitar la complejidad reduce el overfitting estructural desde el origen. |
| Condiciones de salida | 1 a 2 condiciones | Salidas simples generalizan mejor que las complejas. |
| Stop Loss | ATR opcional o pips fijos (40-350) | Usa una modalidad u otra, no ambas a la vez, para no duplicar la exploración del mismo parámetro. |
| Algoritmo | Genético (GA) o aleatorio | El GA es más rápido en volúmenes grandes; el aleatorio aporta más diversidad de partida. |
| Número de islas | 7 | Cada isla evoluciona de forma independiente, lo que evita que el algoritmo converja demasiado pronto hacia soluciones parecidas. |
| Factor de población | 1 | Combinado con las 7 islas, maximiza la variedad de lógicas generadas. |
| Money Management | Lote fijo, sin optimizar | Optimizar el MM en esta fase introduciría sesgo en la evaluación de la lógica pura. |
| Objetivo de cantidad | 5.000 - 10.000 estrategias | Volumen suficiente para que los filtros posteriores sean estadísticamente válidos. |
CLAVE PRÁCTICA
Aumentar el número de islas a 7 es clave para la diversidad genética. Cada isla es una población independiente que evoluciona por separado, generando lógicas de trading radicalmente distintas entre sí — esto contrarresta la tendencia natural del algoritmo genético a converger prematuramente hacia soluciones similares.
Ten en cuenta también que activar la opción de simetría (Symmetry) obliga al Builder a generar también operaciones de venta en activos con sesgo alcista estructural, como el oro — algo a valorar según si buscas un universo equilibrado en ambas direcciones o prefieres dejar que el algoritmo explore libremente.
Paso 2: primer filtrado — retest en un mercado diferente
Este filtro es conceptualmente simple pero muy efectivo. Si una estrategia generada en un índice también genera beneficio en otro índice correlacionado pero con dinámica distinta, hay una evidencia inicial de que su lógica captura algún patrón general y no está simplemente ajustada al ruido específico del primer activo. Un ejemplo típico es generar el universo inicial sobre un índice como el Nasdaq y usar el Dow Jones como mercado de contraste: comparten un componente común de renta variable estadounidense, pero su composición y comportamiento intradía son distintos.
- Exporta el databank completo del Builder con todas las estrategias generadas.
- Impórtalo en el módulo de Retest.
- Configura el activo secundario y los mismos parámetros de spread y comisiones que usarías en real.
- Ejecuta el retest masivo sobre todo el databank.
- Aplica el filtro: conserva únicamente las estrategias con Profit Factor superior a 1 en el nuevo mercado.
El Retest no está pensado para lanzarse estrategia por estrategia: su función de retest por lotes toma directamente el databank entero y lo vuelve a probar de una sola vez, lo cual es imprescindible cuando hablas de miles de candidatas. Si además activas varios símbolos y varios timeframes a la vez en la misma pasada, la herramienta prueba automáticamente cada estrategia contra todas las combinaciones posibles de símbolo y timeframe habilitadas, sin que tengas que configurar cada combinación por separado.
Para el spread, la comisión, el swap y el slippage, puedes elegir entre aplicar el valor original con el que se generó cada estrategia, forzar un valor personalizado para toda la tanda, o usar el valor típico del instrumento — una distinción útil cuando quieres endurecer deliberadamente las condiciones de todo el retest respecto a las que se usaron en la generación.
IMPORTANTE
Asegúrate de que el spread y las comisiones configuradas en el Retest reflejan condiciones reales de mercado, no condiciones idealizadas. Un error común es usar un spread demasiado bajo, lo que infla artificialmente el Profit Factor, sobre todo en estrategias con muchas operaciones cortas.
CLAVE PRÁCTICA
En esta fase, un filtro demasiado estricto eliminaría estrategias válidas que simplemente rinden peor en el mercado secundario porque no fueron pensadas para él. El objetivo aquí es solo descartar las que claramente pierden dinero fuera de su entorno de origen — por eso basta con Profit Factor > 1, no un umbral más exigente.
Paso 3: segundo filtrado — Monte Carlo y ratio Retorno/Drawdown
Las estrategias que superan el retest cruzado pasan ahora por pruebas de robustez estadística, que evalúan si el rendimiento observado podría deberse simplemente al azar.
El Monte Carlo en esta fase del Builder trabaja directamente sobre la lista de operaciones que ya tienes calculada, sin necesidad de volver a ejecutar el backtest — es precisamente esa ligereza lo que permite aplicarlo sobre miles de estrategias sin que el proceso se eternice. Existen dos formas principales de generar las simulaciones:
- Reordenar aleatoriamente la secuencia de operaciones, manteniendo las mismas operaciones pero cambiando el orden en que se sucedieron, para ver cómo varía el camino (y sobre todo el drawdown) que habría seguido la curva de equity.
- Eliminar operaciones al azar con una probabilidad determinada, simulando qué pasaría si algunas operaciones simplemente no se hubiesen producido — por ejemplo, por un fallo de conexión o de ejecución en real.
Con 1.000 simulaciones se obtiene una distribución robusta del comportamiento potencial de la estrategia. El nivel de confianza exigido no tiene por qué ser fijo en el 90%: los niveles habituales son 80%, 90% y 95%, y puedes moverte entre ellos según lo exigente que quieras ser en esta fase — cuanto mayor la confianza exigida, menos estrategias pasan pero más fiables son las que sobreviven.
Junto al Monte Carlo, aplica un filtro por Ratio Retorno/Drawdown, que mide cuánto retorno se genera por cada unidad de riesgo asumida:
| Ratio Retorno/DD | Interpretación | Acción |
| < 1 | Ineficiente: más riesgo que retorno | Descartar |
| 1 - 2 | Aceptable, sin margen de seguridad amplio | Continuar con precaución |
| > 2 | Alta eficiencia riesgo/retorno | Conservar para la siguiente fase |
Al configurar el ranking por este ratio, exige siempre un valor mínimo un punto por encima del umbral que usaste como filtro, para evitar aceptar estrategias que apenas rozan el límite.
Paso 4: tercer filtrado — Walk-Forward Matrix, la prueba de fuego
Este es el filtro más exigente y el más importante de todo el proceso. La versión simplificada de este criterio, y la más habitual para tiradas masivas, consiste en dividir el histórico en dos tramos y comprobar que la pendiente de la curva de equity en el tramo Out-of-Sample (el que la estrategia no vio durante la optimización) es igual o mejor que en el tramo In-Sample.
Pero conviene conocer también la versión completa de la herramienta, que es más rica de lo que sugiere esa comparación simplificada: la Walk-Forward Matrix no ejecuta un único test IS/OOS, sino una auténtica matriz de walk-forwards, combinando distintos números de periodos de reoptimización con distintos porcentajes de Out-of-Sample. El resultado se visualiza como un mapa de calor o gráfico tridimensional sobre la métrica que elijas (beneficio neto, drawdown, estabilidad, Profit Factor...), donde cada celda de la matriz es una combinación concreta de "número de reoptimizaciones × % de OOS" y se marca como superada o fallida.
| Estrategia robusta (conservar) | Estrategia sobreajustada (descartar) |
| Pendiente OOS mayor o igual que la pendiente IS | Pendiente OOS menor que la pendiente IS |
| La curva de equity sigue creciendo fuera de muestra | Rinde mucho mejor en datos ya conocidos que en datos nuevos |
| Patrón estable y generalizable | Señal clara de sobreoptimización |
CLAVE PRÁCTICA
Las estrategias que superan la Walk-Forward Matrix con pendiente OOS igual o mejor que la IS son las que en la jerga del proceso se llaman "bolas blancas": representan típicamente menos del 1% del universo inicial, pero concentran la mayor probabilidad de ser rentables a largo plazo en mercado real.
Un criterio más exigente que la simple comparación de pendientes es buscar un clúster de robustez: en lugar de fijarte en una sola combinación de parámetros, comprueba si existe un grupo compacto de combinaciones vecinas en la matriz —por ejemplo, un bloque de 3×3 combinaciones de periodos y porcentaje de OOS— donde la gran mayoría de esas celdas (no todas, pero sí la mayoría) superan el test. Que el resultado dependa de un bloque amplio de configuraciones vecinas, y no de un único punto afortunado, es una señal mucho más fiable de que el comportamiento no depende de haber acertado por casualidad con un parámetro concreto.
CLAVE PRÁCTICA
Calcular la matriz completa para miles de estrategias puede ser extremadamente lento. Para tiradas masivas conviene usar el modo de simulación o aproximación de la herramienta, que estima el resultado de la matriz de forma mucho más rápida que el cálculo exacto completo — a costa de algo de precisión — y que es más que suficiente como primer filtro grueso antes de recalcular con precisión total solo las candidatas que ya han sobrevivido a las fases anteriores.
Algunas variantes y matices adicionales que conviene conocer sobre este filtro:
- Cuando el Walk-Forward se configura con dos tramos Out-of-Sample independientes, una versión más estricta del criterio exige que el ángulo de la curva supere al del In-Sample en cada tramo por separado y también en el tramo combinado de ambos — en la práctica esta versión de tres condiciones puede resultar incluso más permisiva en algunas tiradas que exigir solo la pendiente global, así que conviene probar ambas variantes con tus propios datos.
- Puedes añadir un criterio adicional: que la racha máxima de pérdidas consecutivas en el Out-of-Sample sea igual o menor que en el In-Sample, como señal extra de que el comportamiento no empeora fuera de muestra.
- Si el filtro de pendiente resulta demasiado restrictivo, antes de relajar el criterio prueba primero a ampliar el histórico uno o dos años: a menudo el problema no es la estrategia, sino que el tramo Out-of-Sample es demasiado corto para ser representativo.
- En una tirada real aplicando este criterio de forma exacta, solo un 6% de las estrategias que llegaron hasta esta fase lo superaron — una muestra de lo exigente que resulta este último filtro cuando se aplica sin concesiones.
En la fase final, muchos no aplican ranking alguno entre las supervivientes: si una estrategia ha pasado todos los filtros de robustez, ya es una "bola blanca" por derecho propio, y no hace falta ordenarlas entre sí antes de pasarlas a portfolio.
Filtrado avanzado dentro del databank
Todo el embudo anterior se apoya, en la práctica, en las herramientas de filtrado y ranking del propio databank, que conviene conocer para exprimir mejor el proceso.
El databank no guarda todo lo que generas de forma indefinida: normalmente se configura para conservar solo las mejores N estrategias (por ejemplo, las 100 o 1.000 mejores), ordenadas por un valor de fitness entre 0 y 1 calculado a partir del Profit Factor o de una fórmula de fitness ponderada que tú mismo puedes definir combinando varias métricas.
Los filtros avanzados o personalizados que puedes construir sobre el databank no se limitan a un puñado de métricas fijas: pueden aplicarse prácticamente sobre cualquier estadística del backtest o de las pruebas de robustez, y —esto es importante para todo lo descrito en este artículo— cada métrica puede filtrarse por separado según el tramo de datos al que pertenece: In-Sample, Out-of-Sample, el resultado de las pruebas de robustez (Monte Carlo, Walk-Forward, etc.) o el resultado agregado de portfolio. Esto te permite, por ejemplo, construir un único filtro compuesto que exija Profit Factor > 1 en el tramo OOS y, al mismo tiempo, confianza Monte Carlo > 90% en el tramo de robustez, sin tener que aplicar cada condición en pasadas separadas.
Dos métricas de simetría, poco conocidas pero útiles para detectar sesgos direccionales sospechosos, completan el conjunto: una que compara cuántas operaciones se han hecho en largo frente a corto, y otra que compara el rendimiento neto entre ambas direcciones. Una estrategia con una simetría muy desequilibrada —por ejemplo, casi todo el beneficio concentrado en el lado largo de un índice que ha sido estructuralmente alcista durante el periodo de backtest— es una candidata más sospechosa de estar ajustada a la tendencia del histórico que a un patrón de mercado genuino.
Comparar visualmente a las estrategias supervivientes
Una vez completado el embudo, es habitual quedarse con dos poblaciones: las que superaron los filtros iniciales y el subconjunto más reducido que además superó la Walk-Forward Matrix. Comparar ambas poblaciones visualmente, y no solo por sus medias agregadas, ayuda a confirmar que el filtrado ha sido realmente efectivo y no un artefacto de cómo se han promediado los números.
Una forma práctica de automatizar esta comparación es exportar cada población a un archivo CSV independiente (por ejemplo, uno con las estrategias que pasaron el filtrado inicial y otro con las que además superaron la Walk-Forward Matrix) y procesarlos con un script sencillo —en Python o en cualquier otro lenguaje con el que te manejes— que genere automáticamente dos histogramas de retorno superpuestos, uno por población, junto con un pequeño resumen estadístico comparativo. No hace falta nada sofisticado: el objetivo es simplemente ahorrarte reconstruir el gráfico a mano cada vez que repites el proceso sobre un activo distinto.
Si el filtrado ha funcionado, el histograma de la población final debería aparecer visiblemente desplazado hacia valores de retorno más altos y con menos dispersión que el histograma de la población descartada en el último paso — una diferencia que debería ser evidente a simple vista, no algo que necesites entrecerrar los ojos para apreciar.
CLAVE PRÁCTICA
Tras el análisis visual, puedes aplicar un filtro adicional por número máximo de pérdidas consecutivas. Estrategias con más de 8-10 pérdidas seguidas, aunque sean rentables en conjunto, pueden ser psicológicamente difíciles de operar y requerir un colchón de capital mayor del que habías estimado.
Checklist completo de validación
Generación
- Activo y timeframe definidos con una justificación clara.
- Builder configurado con varias islas y factor de población bajo.
- Money Management en lote fijo durante toda la generación.
- Objetivo mínimo de varios miles de estrategias alcanzado.
Filtrado inicial
- Retest por lotes ejecutado sobre el databank completo, en un mercado diferente pero correlacionado.
- Spread, comisiones, swap y slippage del Retest ajustados a condiciones reales, no a los valores originales de generación.
- Filtro de Profit Factor > 1 aplicado correctamente.
Robustez estadística
- Monte Carlo ejecutado con un mínimo de 1.000 simulaciones, combinando reordenación y eliminación aleatoria de operaciones.
- Solo se conservan estrategias con la confianza mínima que hayas fijado (80%, 90% o 95%).
- Filtro de Ratio Retorno/Drawdown aplicado (idealmente por encima de 2).
Validación Out-of-Sample
- Walk-Forward Matrix ejecutada, al menos en modo de simulación rápida, sobre todo el subconjunto superviviente.
- Pendiente OOS verificada como igual o mejor que la IS, idealmente respaldada por un clúster de combinaciones vecinas y no por un único punto de la matriz.
- Análisis visual de las curvas de equity completado, no solo numérico.
Selección final
- Comparación visual entre la población filtrada y la descartada realizada, idealmente con un script propio que automatice los histogramas.
- Máximo de pérdidas consecutivas y simetría direccional evaluados y considerados aceptables.
- Cada estrategia final revisada manualmente, no solo por sus estadísticas.
- Condiciones de mercado del periodo de backtest documentadas.
Errores frecuentes y cómo evitarlos
| Error frecuente | Solución |
| Spread demasiado bajo en el Retest | Usa siempre el spread real del bróker. Un spread optimista puede duplicar artificialmente el Profit Factor en estrategias con muchas operaciones cortas. |
| Generar pocas estrategias (menos de 1.000) | Con pocas estrategias, los supervivientes del filtro no son estadísticamente representativos. Apunta a varios miles como mínimo. |
| Optimizar el Money Management desde el inicio | Fija el lote en la generación. El MM debe optimizarse solo después de validar la lógica de forma independiente. |
| Ignorar el análisis visual del Out-of-Sample | Nunca confíes solo en los números. Una estrategia puede pasar el filtro numérico OOS pero tener una curva irregular con periodos de drawdown inaceptables. |
| Usar un solo mercado en todo el proceso | La validación cruzada entre mercados es fundamental. Una estrategia que solo funciona en un activo concreto tiene alta probabilidad de estar ajustada a ese activo. |
| Elegir la estrategia con mejor rendimiento histórico | El objetivo no es la mejor estrategia histórica, sino las más robustas. Un retorno moderado pero consistente es preferible a uno alto pero inconsistente. |
| Fiarse de una sola celda de la Walk-Forward Matrix | Un único test IS/OOS superado puede ser casualidad. Buscar un clúster de combinaciones vecinas que también superen el test da mucha más confianza en el resultado. |
| Ignorar la simetría direccional de las operaciones | Una estrategia con casi todo su beneficio concentrado en una sola dirección puede estar ajustada a la tendencia del periodo de backtest más que a un patrón de mercado real. |
Validación Masiva y Custom Project Multinivel
La Validación Masiva descrita en este artículo tiene una evolución natural: separar por completo la búsqueda de la lógica de entrada/salida de la optimización de sus parámetros, en dos niveles sucesivos de Builder. Es un enfoque más laborioso, pero que suele producir estrategias de mayor calidad.
| Criterio | Validación Masiva estándar | Custom Project Multinivel |
| Complejidad | Media | Alta |
| Tiempo requerido | Horas o días | Días o semanas |
| Control del sobreajuste | Alto | Muy alto |
| Separación lógica/parámetros | No, se optimizan a la vez | Sí, en dos niveles |
| Recomendado para | Búsqueda general | Portfolios profesionales |
El desarrollo completo de esta metodología en dos fases —con su propio checklist y sus propias pruebas de robustez— tiene su artículo dedicado dentro de esta misma serie.
Resumen ejecutivo
La Validación Masiva invierte el paradigma tradicional de creación de estrategias: en lugar de optimizar una única estrategia hasta hacerla "perfecta", genera miles de candidatas y aplica filtros progresivos hasta conservar solo las que demuestran robustez genuina. El proceso se sostiene sobre cinco pilares:
- Diversidad: generar un universo amplio, con parámetros variados y varias islas genéticas.
- Validación cruzada: demostrar que la lógica funciona también en mercados no vistos durante la generación, aprovechando el retest por lotes sobre el databank completo.
- Robustez estadística: confirmar mediante Monte Carlo que el rendimiento no es fruto del azar.
- Generalización Out-of-Sample: verificar, idealmente con un clúster de combinaciones y no un único test, que la estrategia mantiene su rendimiento en periodos que no vio durante la optimización.
- Filtrado inteligente en el databank: usar el fitness, los filtros por tramo (IS/OOS/robustez/portfolio) y las métricas de simetría para automatizar y afinar cada etapa del embudo.
Preguntas frecuentes (FAQs)
¿Por qué generar miles de estrategias en vez de intentar optimizar una sola desde el principio?
Porque la fiabilidad de este método es estadística, no individual. Optimizar una única estrategia hasta que "funcione" en el histórico no dice nada sobre si ese resultado es genuino o casualidad; generar un universo amplio y filtrarlo progresivamente permite quedarte solo con las que demuestran robustez de forma consistente y repetida.
¿Qué significan las "bolas blancas" en este proceso?
Es la forma habitual de referirse a las estrategias que superan absolutamente todos los filtros, incluida la Walk-Forward Matrix. Suelen representar menos del 1% del universo inicial, pero son las que concentran la mayor probabilidad de comportarse bien en mercado real.
¿La Walk-Forward Matrix es solo una comparación entre la pendiente In-Sample y la Out-of-Sample?
Esa es la versión simplificada y más habitual para filtrar tiradas masivas, pero la herramienta completa va más allá: calcula toda una matriz combinando distintos números de reoptimizaciones con distintos porcentajes de Out-of-Sample, y permite buscar un clúster de combinaciones vecinas que superen el test, en lugar de fiarte de un único resultado puntual.
¿Es viable calcular la Walk-Forward Matrix completa sobre miles de estrategias?
En su modo de cálculo exacto puede ser muy lento a esa escala. Para tiradas masivas conviene usar primero el modo de simulación o aproximación, que estima el resultado mucho más rápido, y reservar el cálculo exacto y completo solo para las candidatas que ya han superado el resto del embudo.
¿Hace falta retestar las estrategias una por una en el segundo mercado?
No. El retest está pensado para trabajar sobre el databank completo de una sola vez, e incluso puede probar automáticamente cada estrategia contra varias combinaciones de símbolo y timeframe a la vez si las activas todas en la misma pasada.
¿Es imprescindible una herramienta de análisis visual para completar la validación masiva?
No es obligatorio, pero ayuda mucho a confirmar que el filtrado ha sido efectivo. Puedes automatizarlo exportando cada población a un archivo CSV y generando los histogramas con un script sencillo, o revisar manualmente las curvas de equity y las métricas agregadas de cada grupo si lo prefieres.
¿Qué relación tiene la Validación Masiva con el Custom Project Multinivel?
El Multinivel es una versión más exigente de la misma filosofía: en vez de optimizar lógica y parámetros a la vez como en la Validación Masiva estándar, los separa en dos niveles sucesivos. Ambos enfoques son compatibles entre sí y pueden aplicarse sobre el mismo activo para comparar resultados.
Sigue leyendo el contenido de esta serie
Custom Projects en StrategyQuant: la guía completa
Qué son, cómo funcionan y por qué son la herramienta que separa a un trader que prueba cosas...
Cómo crear tu primer Custom Project en StrategyQuant
La interfaz explicada pantalla por pantalla y zona por zona, cómo crear tu primer proyecto y qué...
Catálogo completo de tareas en Custom Projects de StrategyQuant
Todas las tareas disponibles para construir un flujo — qué hace cada una, cómo se configura y...
Bucles, Copy Config y gestión de memoria en Custom Projects
Cómo automatizar la repetición de un flujo con Go To Task, evitar errores de configuración con...
Pruebas de robustez en StrategyQuant: Monte Carlo, Walk-Forward y SPP
Los métodos que separan una estrategia con lógica real de una simplemente ajustada a los datos del...
Custom Project completo para XAUUSD H1: flujo paso a paso
Un flujo de trabajo profesional real, tarea por tarea, con los databanks, filtros y resultados...
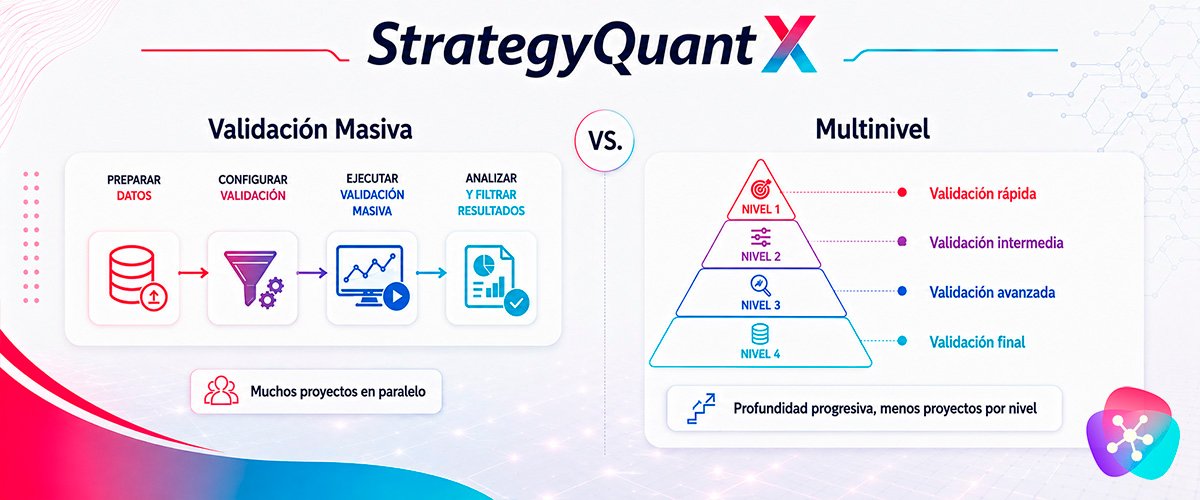
Validación Masiva vs. Multinivel: dos metodologías de Custom Project
Cuándo conviene cada enfoque, cómo gestionar el brazo short, instalar indicadores externos y qué...
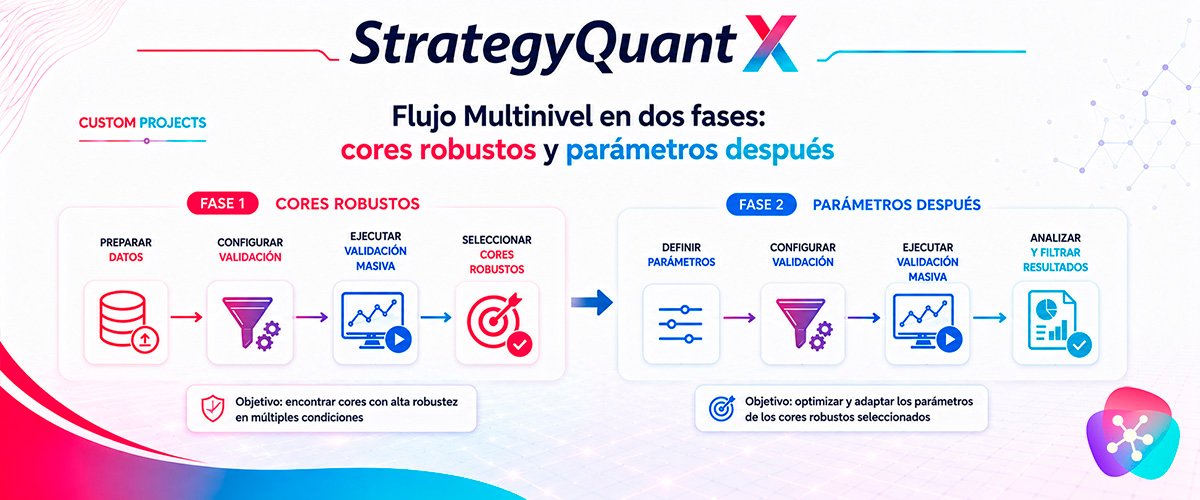
Flujo Multinivel en dos fases: cores robustos y parámetros después
La metodología completa —Fase 1 para encontrar la lógica, Fase 2 para pulirla y estresarla— con su...
Errores frecuentes y checklist final en Custom Projects
Los fallos conceptuales y de configuración más habituales, y la lista de verificación antes de...